第 1 章:业务问题与产品边界
本章目标
完成本章后,你应该能够:
- 解释为什么 Data Agent 项目不能从聊天界面或模型选型开始。
- 把模糊的“做一个数据助手”改写成可验证的业务问题清单。
- 为每个回答定义指标、时间、维度、证据和安全边界。
- 区分当前已经实现的能力和产品路线图中的扩展能力。
- 产出第一版业务问题契约和项目验收标准。
开始之前
本章不要求运行大模型,也不要求先理解全部代码。建议先浏览:
- 项目 README
docs/01-product-blueprint.mddocs/05-evaluation-set.md
本章的核心产物不是代码,而是一份能约束后续建模、指标和 Agent 开发的业务契约。
1. 从一个真实问题开始
设想电商运营负责人提出问题:
上个月哪个渠道销售额下降最严重,原因是什么?
表面上这只是一个自然语言问题,实际上至少包含六个需要确定的决策:
| 决策 | 需要明确的内容 |
|---|---|
| 指标 | “销售额”是下单金额、支付金额还是扣除退款后的净收入 |
| 时间 | “上个月”依据自然月还是最近 30 天 |
| 维度 | 渠道使用投放渠道、来源平台还是订单归因渠道 |
| 对比 | 与前一个自然月、去年同期还是目标值对比 |
| 原因 | 用流量、转化率、客单价还是商品结构做拆解 |
| 证据 | 返回哪些数字、SQL、口径和数据来源才能复核 |
如果这些决策没有被产品和数据契约明确,大模型生成了一条语法正确的 SQL,也可能得到业务上错误的答案。
因此,本项目的起点不是“让模型生成 SQL”,而是:
先定义系统必须稳定回答哪些问题,再反推需要怎样的数据模型、指标口径和分析工具。
2. 为什么不能只做 Text-to-SQL
Text-to-SQL 解决的是“如何把一句话翻译成 SQL”。经营分析还要求系统解决:
- 用户说的业务词对应哪个指标定义。
- 指标应该使用哪个时间字段和数据粒度。
- 一个复杂问题需要执行几次查询。
- 查询结果是否足以支持“原因”结论。
- SQL 是否安全、可执行、可追踪。
- 后续追问应该沿用哪些上下文。
- 历史报告如何保持保存时的数值不变。
所以 Data Agent Studio 把一次分析拆成可检查的链路:
业务问题
-> 指标与时间语义
-> 分析计划
-> 受控指标查询
-> SQL 安全校验
-> 数仓执行
-> 结果解释
-> 证据链与报告快照
大模型可以参与“理解”和“解释”,但不能替代指标语义层,也不能绕过查询和安全边界。
3. 产品定义
Data Agent Studio 的第一版定义是:
一个面向电商经营分析的可信数据 Agent 工作台。用户使用自然语言提出经营问题,系统基于预先定义的数仓和指标口径制定分析计划,执行只读查询,并返回结论、图表、SQL、假设和可保存的报告快照。
这里有四个关键词:
- 电商经营分析:先做深一个业务领域,不承诺任意行业通用。
- 可信:回答必须带时间范围、指标口径、查询记录和限制说明。
- 预先定义:Agent 使用指标和维度契约,不临时猜测全部业务逻辑。
- 只读查询:Agent 不修改业务数据,也不能自由执行任意 SQL。
4. 系统边界
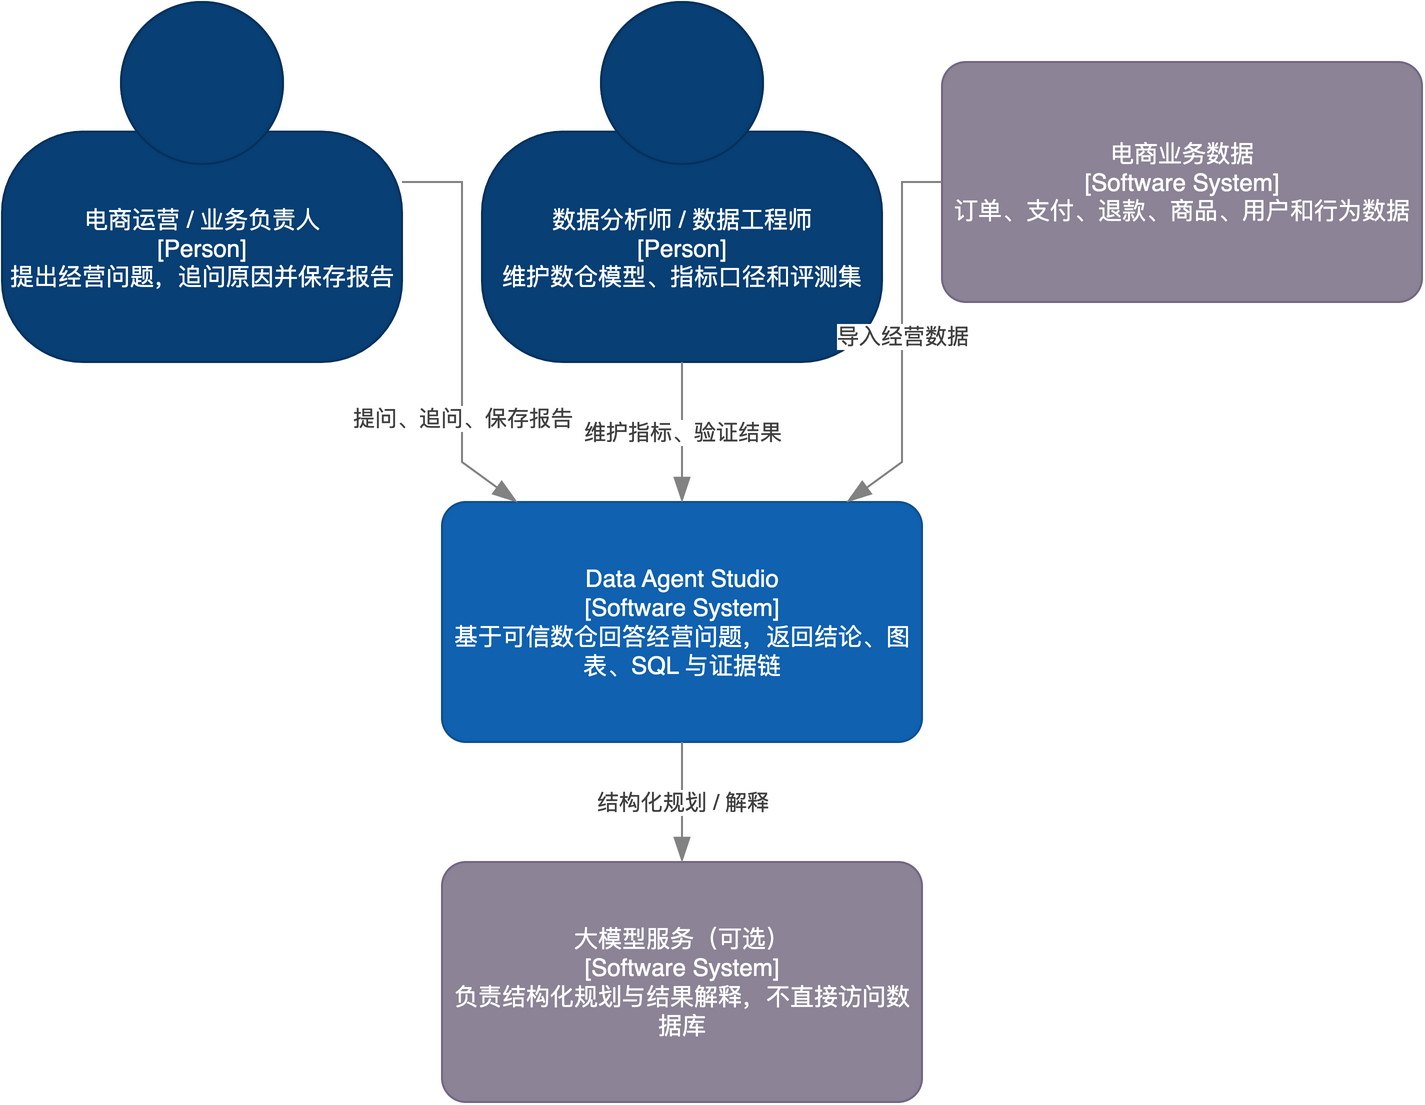
这张系统上下文图表达了三个重要边界:
- 电商运营和业务负责人负责提出问题、追问和消费报告。
- 数据分析师和数据工程师负责维护模型、指标口径和评测标准。
- 大模型服务是可选能力,只接收受控的计划上下文或查询结果,不直接访问 DuckDB 和 SQLite。
可编辑架构图见 Draw.io 源文件。
5. 当前已经实现什么
为了避免教程和产品宣传超过实际能力,本项目使用明确的状态表。
已实现
- 电商样例数据生成和 DuckDB 数仓构建。
- ODS、DIM、DWD、DWS 分层模型。
- GMV、支付订单数、客单价、访客数、转化率、退款率和复购率等指标。
- 规则规划器和可选 OpenAI-compatible 大模型规划器。
- 单指标、排名、日期趋势、周期对比和渠道诊断。
- SQLGlot 只读 SQL 校验和指标查询服务。
- 多轮会话、上下文下钻和 SQLite 持久化。
- Web 工作台、结果表、趋势图、证据链和 Markdown 导出。
- 不可变报告快照、会话内版本号和报告库。
- 36 个 Python 单元及 API 测试。
尚未产品化完成
- 面向任意客户的 CSV/Excel 上传和字段映射界面。
- MySQL、PostgreSQL 或云数仓连接器。
- 用户登录、组织、多租户和数据权限。
- Docker 一键部署、监控和生产运行手册。
- 完整的 30~50 题自动评测报告。
- 商业授权、版本更新和售后支持体系。
这个区分很重要:当前项目已经能教学、演示和本地使用,但不能直接宣传成支持多租户和任意企业数据源的成熟 SaaS。
6. 可信回答契约
一个合格的 Data Agent 回答不只是自然语言结论。每次分析至少需要保留以下内容:
| 字段 | 作用 |
|---|---|
question | 原始业务问题 |
intent | 单指标、排名、趋势、诊断或下钻 |
date_range | 本次分析使用的明确时间范围 |
assumptions | 系统对模糊日期和口径做出的假设 |
plan | 指标、维度、过滤条件和对比周期 |
results | 查询字段、结果、SQL 和执行周期 |
report | 结论、关键发现、限制和后续问题 |
trace_id | 用于追踪一次完整分析 |
对应实现位于:
backend/agent.py:组织分析计划和响应。backend/metric_query.py:执行语义指标查询。backend/session_store.py:持久化会话和报告。frontend/app.js:渲染结论、图表、证据链和报告库。
7. 把业务问题写成可评测契约
“系统支持销售分析”无法验收。下面的结构才能成为开发和测试依据:
| 字段 | 示例 |
|---|---|
| 问题 ID | Q01 |
| 用户问题 | 上个月哪个渠道销售额下降最严重,原因是什么? |
| 指标 | gmv, visitors, conversion_rate, aov |
| 维度 | channel |
| 当前周期 | 最新数据月份 |
| 对比周期 | 前一个自然月 |
| 查询数量 | 当前与上期共 8 次指标查询 |
| 预期证据 | 渠道 GMV 变化及流量、转化率、客单价变化 |
| 安全要求 | 只读 SQL、渠道过滤走维度白名单 |
| 成功标准 | 找到下降最大渠道,关键数字可由 SQL 复核 |
当 20~50 个标准问题都使用这个结构描述时,后续工作会自然收敛:
- 数仓章节知道需要哪些事实和维度。
- 语义层章节知道需要定义哪些指标。
- Agent 章节知道需要哪些分析模板。
- 评测章节知道怎样判断结果是否正确。
- 销售演示知道应该展示哪些真实场景。
8. 一个完整案例如何穿过系统
以渠道诊断问题为例:
- Agent 将“销售额”解析为语义层中的
gmv。 - 时间推理将“上个月”映射为样例数据最新自然月。
- 分析计划选择
channel_diagnosis模板。 - 系统分别查询当前和上一周期的 GMV、访客数、转化率和客单价。
- 每条 SQL 都由查询服务构造并经过 SQLGlot 校验。
- Agent 找出 GMV 下降最大的渠道,并比较三个驱动指标。
- Web 工作台展示结论、结果表、对比图、SQL 和假设。
- 用户继续问“具体是哪些商品”,系统沿用下降渠道作为安全过滤条件。
- 用户保存报告,SQLite 记录这一轮不可变响应和版本号。
这个案例是课程后续章节的主线。每一章都会实现或解释其中一段链路,最终再用自动评测把它串起来。
9. 动手任务:建立业务问题清单
在自己的练习仓库中创建 work/01-business-contract.md,至少写出 10 个问题,覆盖:
- 2 个单指标问题。
- 2 个日期趋势问题。
- 2 个维度排名问题。
- 2 个周期对比问题。
- 1 个原因诊断问题。
- 1 个多轮下钻问题。
每个问题都填写:指标、维度、时间、对比方式、期望证据和安全要求。
推荐表格:
| ID | 用户问题 | 指标 | 维度 | 时间 | 对比 | 期望证据 | 安全要求 |
|---|---|---|---|---|---|---|---|
| Q01 | ... | ... | ... | ... | ... | ... | ... |
不要在这个阶段写 SQL。第一章只定义“系统必须回答什么”和“什么结果算正确”。
10. 验收标准
完成以下检查,本章才算通过:
- 至少定义 10 个具体业务问题。
- 每个问题都能指出一个或多个明确指标。
- 每个指标都说明时间口径。
- 原因问题包含可验证的拆解因素,而不是要求模型自由猜测。
- 多轮问题说明需要沿用的上一轮上下文。
- 每个问题都定义了可复核证据。
- 明确列出当前版本不承诺的能力。
- 能在 3 分钟内向别人解释系统边界和大模型边界。
11. 常见错误
错误一:问题写得太宽
症状:“分析一下经营情况。”
原因:没有指标、时间、维度和成功标准,任何答案都难以判断对错。
修复:改写成“最近 30 天 GMV 和支付订单数的每日趋势如何,异常日期有哪些?”
错误二:把原因分析当作文本生成
症状:模型看到 GMV 下降后,直接猜测是促销、季节或竞争导致。
原因:这些因素没有进入数据模型,查询结果无法支持因果结论。
修复:第一版只拆解可观测的访客数、转化率、客单价和商品结构,并明确“相关性不是因果”。
错误三:先选模型,再找问题
症状:大量时间用于比较模型和提示词,但核心指标仍然没有统一口径。
原因:模型能力无法补偿业务定义缺失。
修复:先固定标准问题和指标契约,再决定哪些语言理解需要大模型。
错误四:把路线图写成已经交付
症状:资料中写了数据上传、多租户和自动评测,但仓库没有对应实现。
原因:产品蓝图和当前版本状态混在一起。
修复:所有功能明确标记为“已实现”“本课程实现”或“扩展练习”。
12. 本章小结
Data Agent 的可信度不是来自回答语气,而是来自业务契约。先把问题、指标、时间、维度、证据和安全要求写清楚,后续的数仓、语义层、Agent 和评测才有共同目标。
第一章的最终产物是一份业务问题清单。下一章将根据这份清单确定业务过程和表粒度,开始构建电商分层数仓。
思考题
- 如果客户把“销售额”定义为扣除退款后的净支付金额,现有
gmv指标应该修改,还是新增指标?为什么? - “哪个渠道效果最好”为什么不能直接作为一个可评测问题?还缺哪些定义?
- 哪些数据可以支持原因拆解,哪些只能支持相关性描述?
- 为什么报告快照应该保存完整响应,而不是只保存最后一段自然语言结论?