第 1 章:业务场景、分析需求与项目边界
本章目标
完成本章后,你应该能够:
- 说明本项目服务的业务角色和经营决策。
- 从业务问题识别订单、支付、退款、行为和商品经营过程。
- 区分指标、维度、业务过程和应用报表。
- 解释为什么项目需要从 ODS 建到 ADS。
- 判断哪些能力已经实现,哪些属于后续生产化扩展。
开始之前
前置知识
- 能阅读基础 SQL,包括
JOIN、GROUP BY和聚合函数。 - 知道订单、支付和退款是不同的业务动作。
- 不要求提前掌握维度建模、DuckDB 或 dbt。
本章会用到的文件
| 文件 | 用途 |
|---|---|
scripts/generate_sample_data.py | 生成确定性的电商源数据 |
contracts/warehouse-v1.yaml | 查看五层模型的粒度契约 |
config/metrics.yaml | 查看 GMV、转化率和退款率定义 |
warehouse/sql/05_ads.sql | 观察最终应用表如何服务经营场景 |
reports/data-quality-latest.json | 查看机器可读的质量验收结果 |
reports/quality-gate-latest.json | 查看统一发布门禁结果 |
先跑通基线
在项目根目录执行:
make setup
make validate
成功后应该看到:
Quality summary: 20/20 passed
Quality evidence: 584/584 upstream checks passed
Quality gate: 53/53 passed
Release gate: PASS
并得到两个独立产物:
dist/ecommerce_warehouse.duckdb
reports/data-quality-latest.json
reports/quality-gate-latest.json
如果命令没有通过,不要继续阅读后面的 SQL。先确认 Python 环境、依赖安装和文件权限,保证学习基线可重复。
1. 业务背景
假设我们服务一家拥有多个店铺、多个商品类目和多个获客渠道的电商业务。运营负责人每天都需要回答类似问题:
- 今天的 GMV、支付订单数和支付用户数是多少?
- 哪个渠道贡献最高,哪个渠道正在下降?
- 销售额变化是访客数、转化率还是客单价造成的?
- 哪些商品销量高但退款率也高?
- 哪些类目的退款需要运营介入?
- 新用户首购后 30 天内是否再次购买?
这些问题看起来是几条 SQL,实际跨越了多个源系统和不同粒度。如果直接连接原始表,很容易出现:
- 把未支付订单算进 GMV。
- 用订单商品行数代替订单数。
- 把多条用户事件与订单明细关联,导致金额重复。
- 把退款发生时间和支付归因时间混为一谈。
- 用事件数而不是去重用户数计算访问人数。
数仓的价值,是提前把这些高风险判断固化成稳定模型和数据契约。
2. 谁会使用这个数仓
| 角色 | 典型决策 | 需要的数据 |
|---|---|---|
| 业务负责人 | 判断整体经营是否健康 | GMV、净收入、订单、转化、退款 |
| 渠道运营 | 调整渠道预算和投放策略 | 访客、支付用户、渠道转化和渠道排名 |
| 商品运营 | 选择主推商品和处理异常退款 | 商品销量、GMV、退款率和七日趋势 |
| 用户运营 | 设计新客和复购活动 | 首购用户、复购用户和 cohort |
| 数据分析师 | 下钻异常并验证原因 | DWD 明细事实和 DWS 主题汇总 |
| 数据应用 | 提供看板、报告或智能分析 | 稳定的 ADS、DWS 和指标口径 |
这里的“数据应用”可以是 BI 看板、经营日报,也可以是 Data Agent。数仓不应该为了某一个界面而失去可复用性。
3. 从问题识别业务过程
本项目第一版覆盖五个业务过程:
| 业务过程 | 发生了什么 | 关键时间 | 核心业务键 |
|---|---|---|---|
| 订单 | 用户提交一笔订单 | created_at | order_id |
| 支付 | 一笔订单发生支付尝试 | paid_at | payment_id |
| 退款 | 一个订单商品行发生退款 | refund_at | refund_id |
| 用户行为 | 用户访问、浏览、加购或购买 | event_at | event_id |
| 商品经营 | 商品在店铺和类目下产生经营结果 | 随事实变化 | product_id |
识别业务过程的目的,不是马上决定表名,而是先确认哪些事实不能混成一张表。
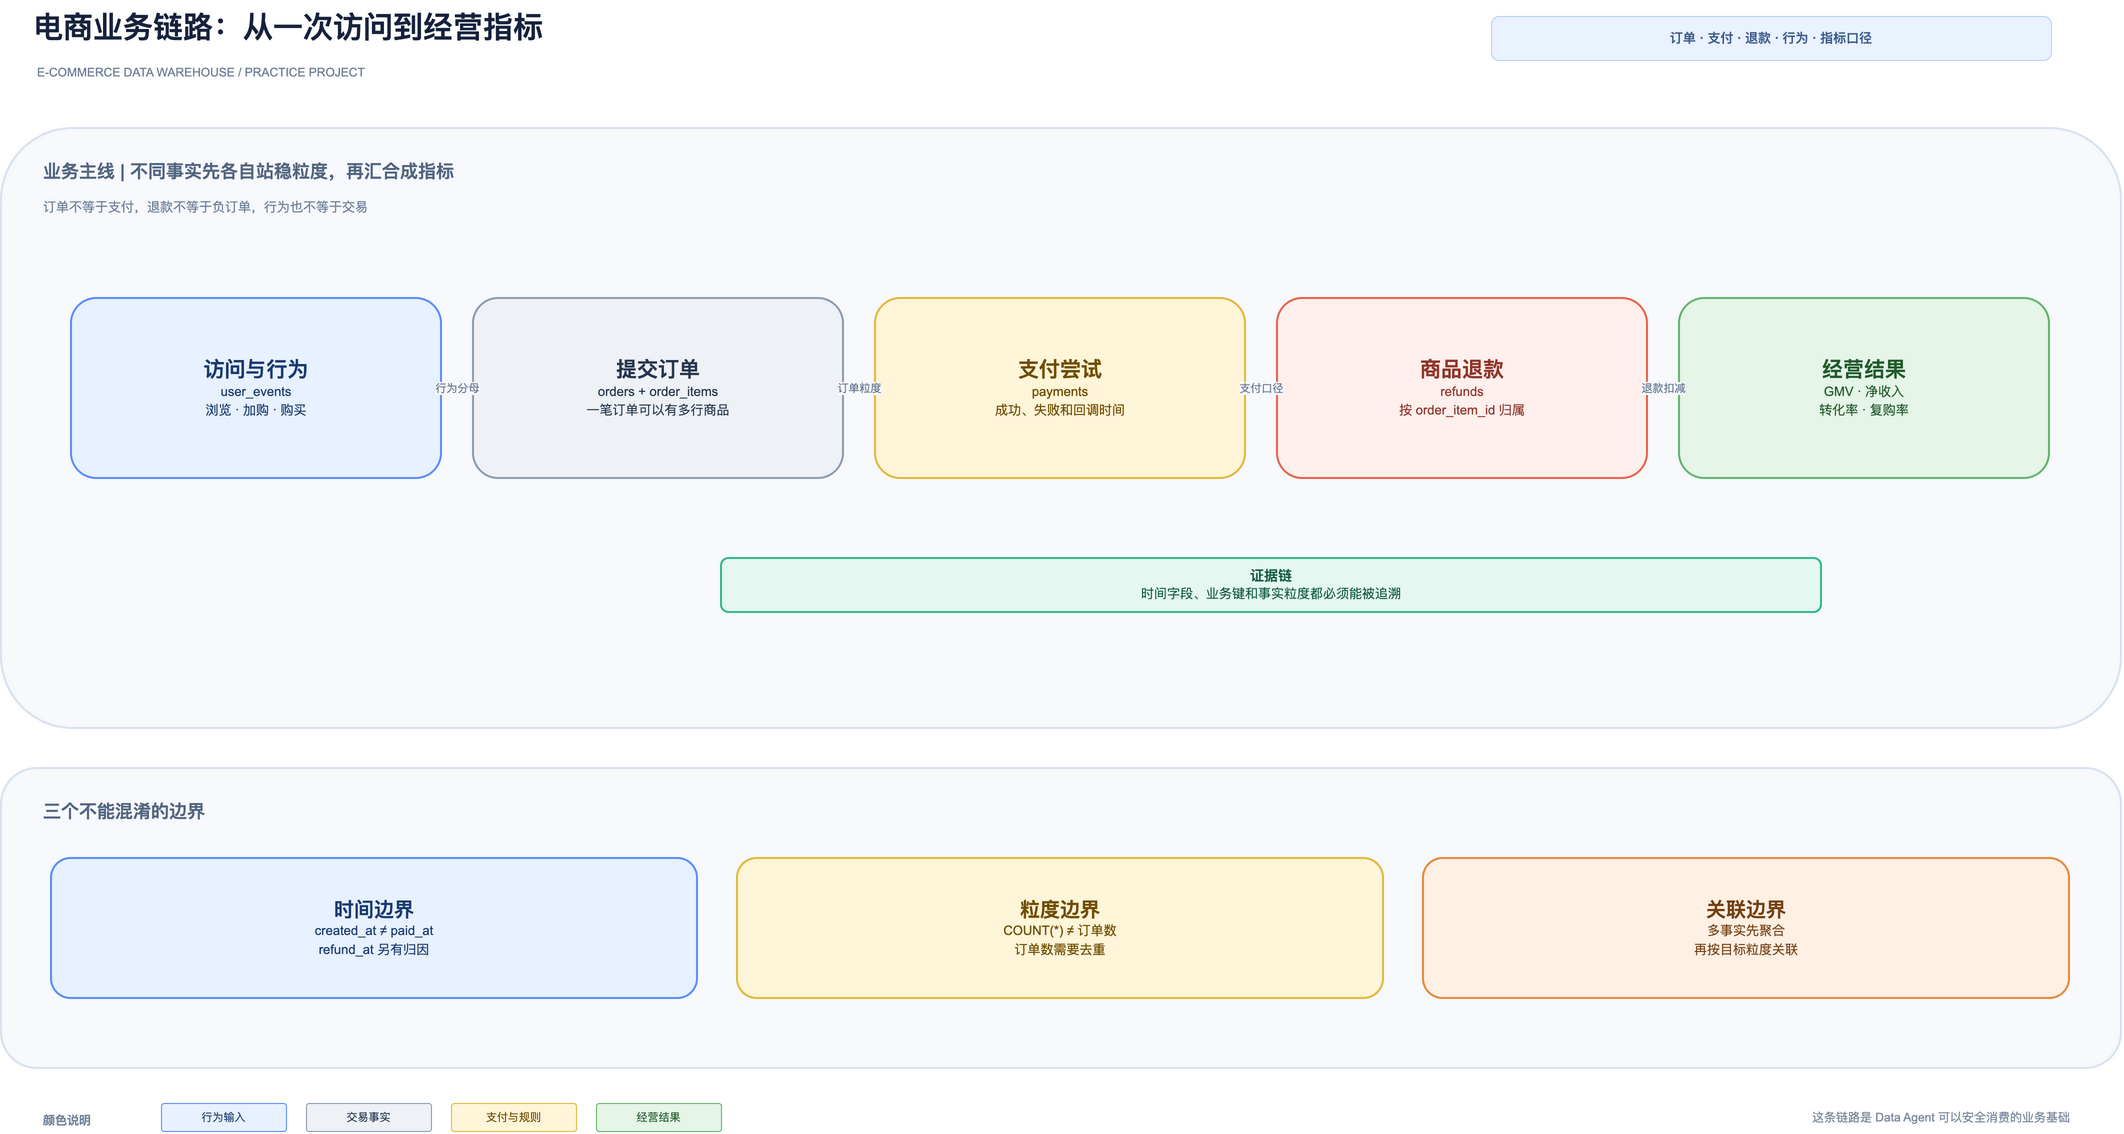
这张图先用一条业务主线建立直觉,后面的事实表设计再分别讨论每个过程的粒度、时间字段和业务键。
订单不等于支付
订单创建后可能取消,支付尝试也可能失败。因此本项目定义:
GMV = 已支付订单商品行的 paid_amount 之和
而不是:
GMV = 所有已创建订单金额之和
退款不等于负订单
退款发生在支付之后,可能只退一个商品行的部分金额。本项目保留独立退款事实,再按订单商品行聚合后关联,避免一对多关系放大金额。
行为不等于交易
同一用户一次会话中可能浏览多个商品、加购多次,最后只生成一笔订单。流量和交易必须先在相同分析粒度分别聚合,再进行关联。
4. 指标树
经营结果可以拆成:
GMV
├── 访客数
├── 支付转化率
└── 客单价

净收入
├── GMV
└── 退款金额

商品经营
├── 支付销量
├── 支付订单数
├── GMV
└── 退款率

用户经营
├── 首购用户数
├── 30 天复购用户数
└── 30 天复购率
常见分解关系是:
GMV ≈ 访客数 × 支付转化率 × 客单价
这个等式帮助我们设计渠道主题表,但不能替代指标口径。访客数的去重范围、支付转化率的分子和客单价的订单去重方式仍然必须明确。
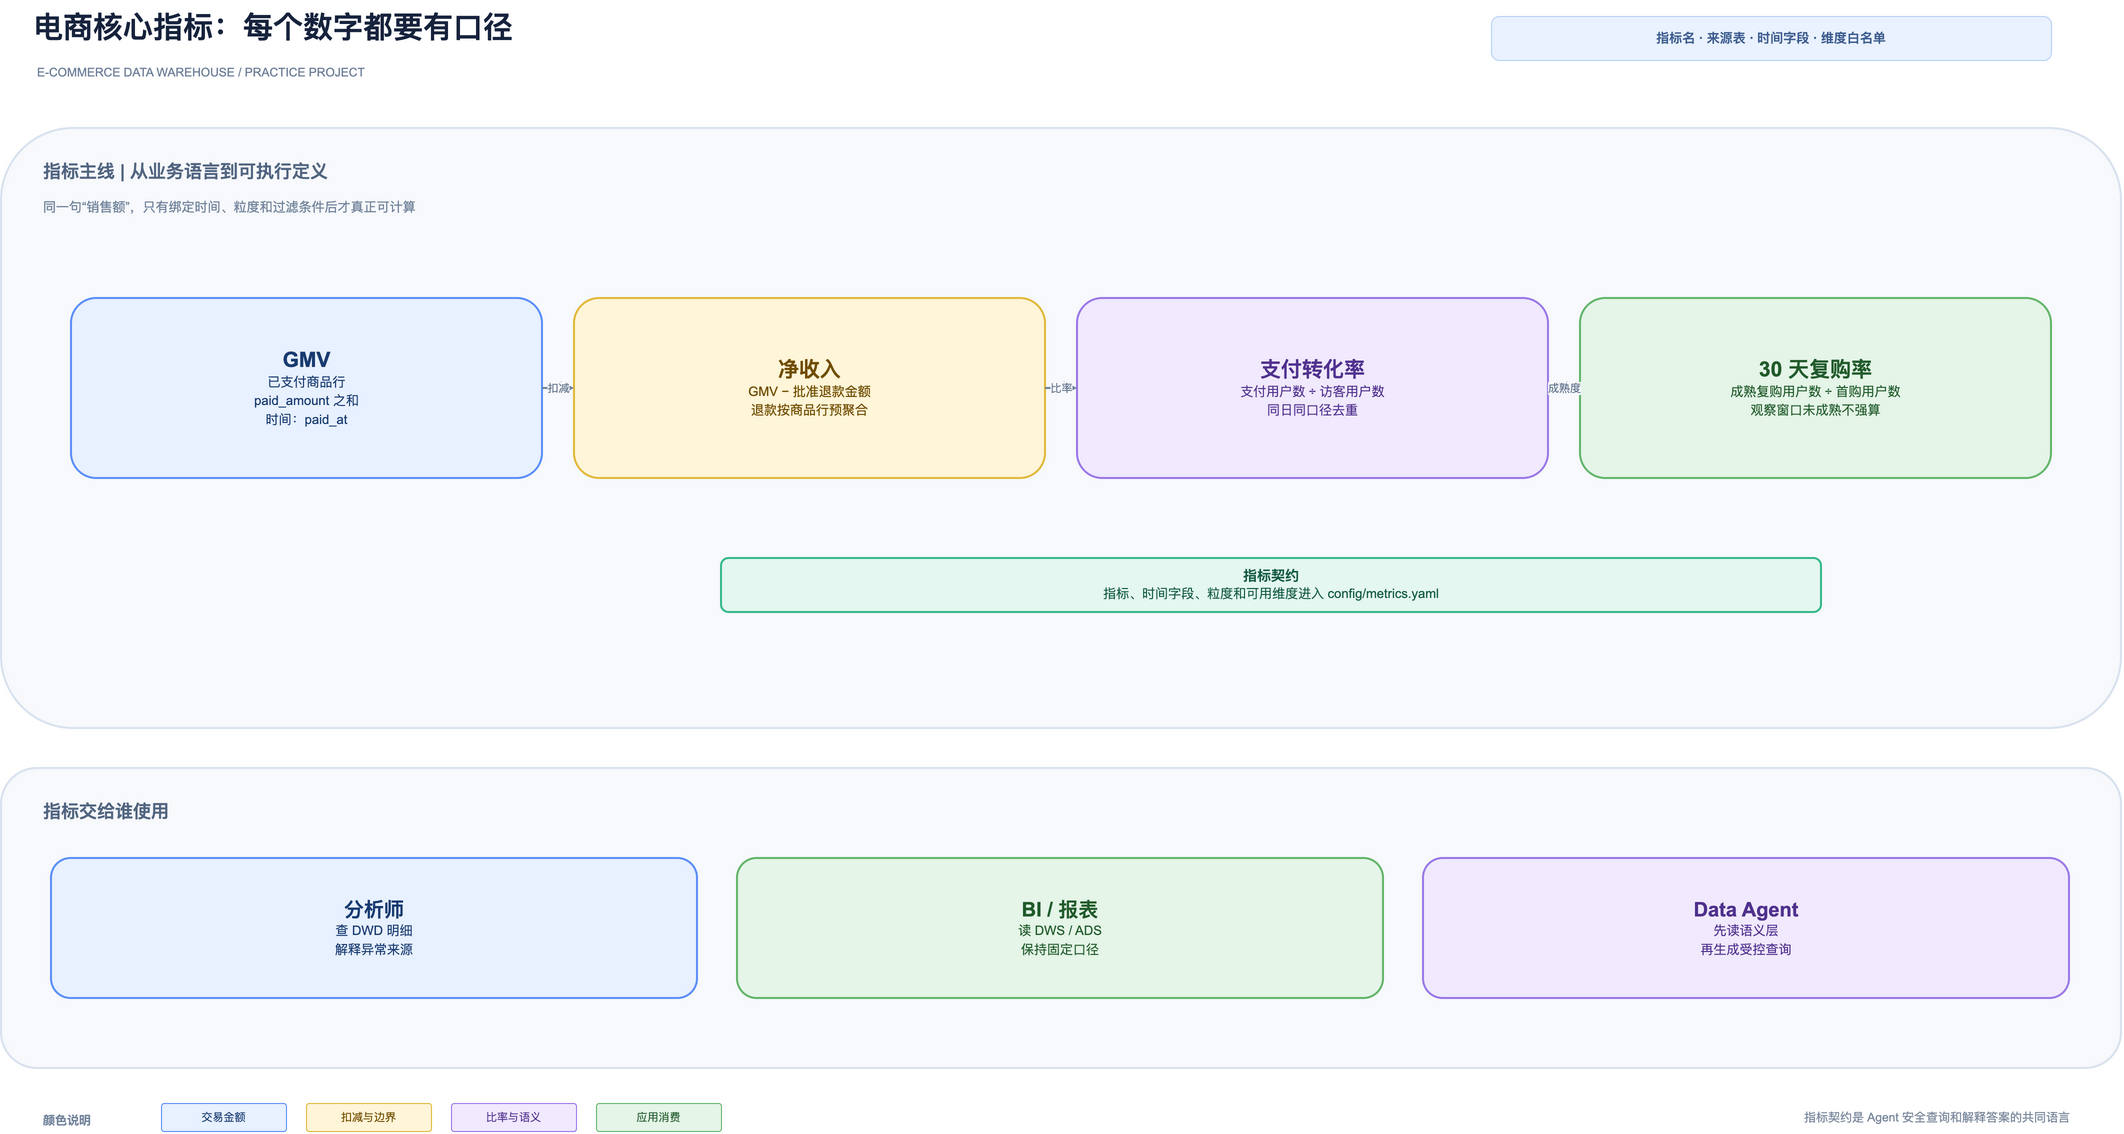
图中的四个指标只是当前项目的代表性口径,完整定义以 config/metrics.yaml 和后续语义层说明为准。
5. 为什么要建到 ADS
本项目采用完整的五层结构:
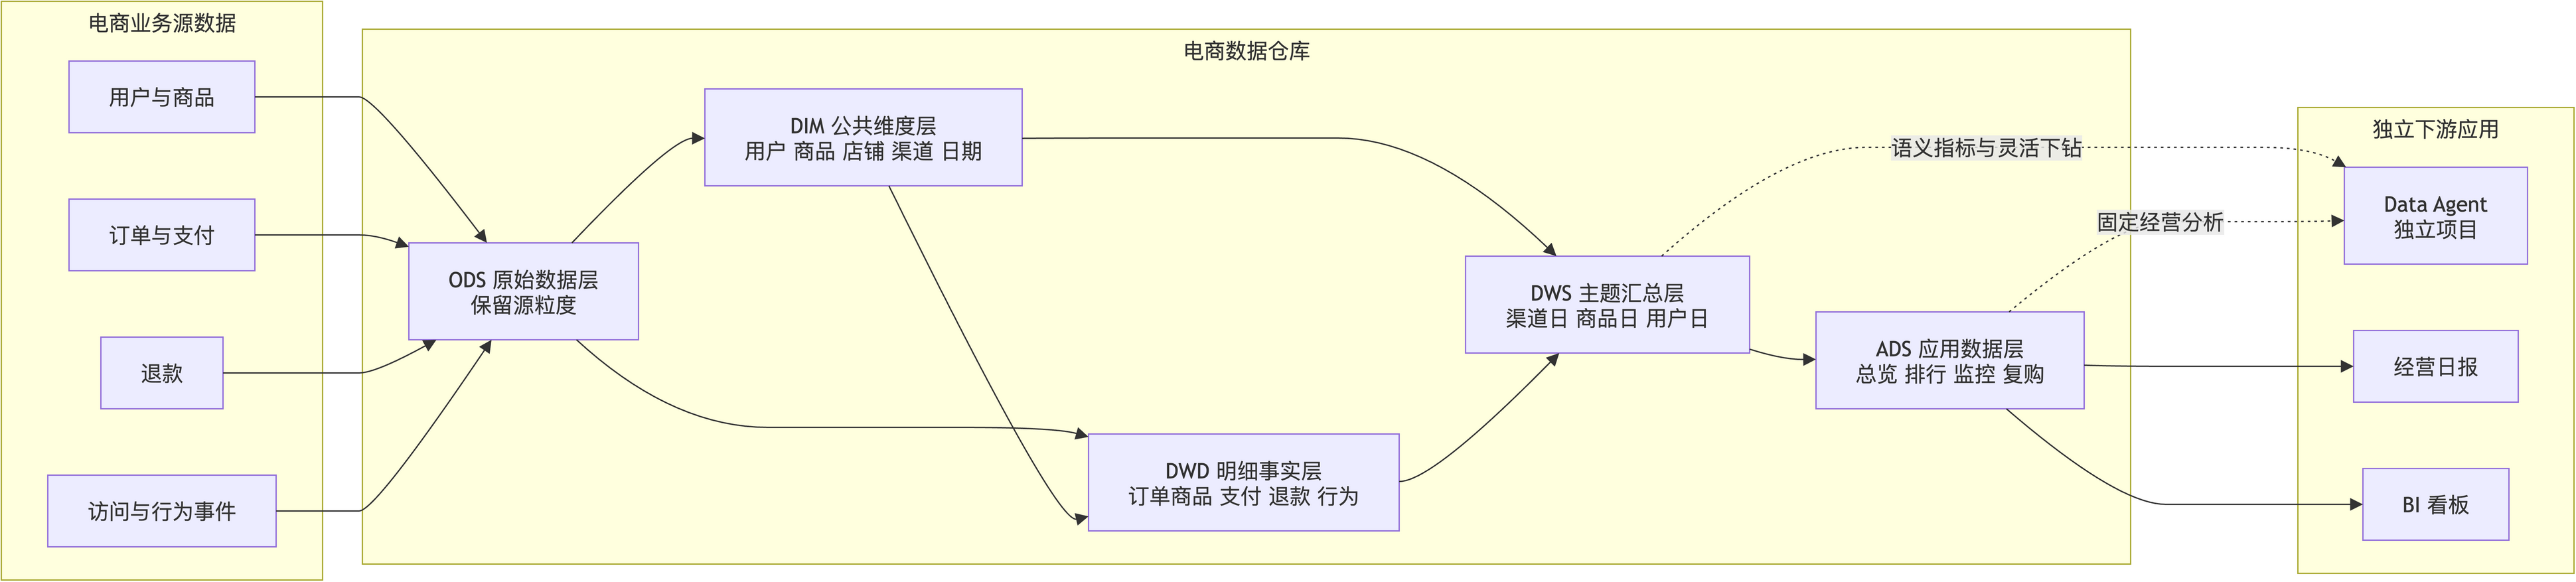
可编辑 Draw.io 源文件见 五层架构图,源描述见 Mermaid 文件。图中的 Data Agent 是独立下游应用,不是本项目的安装依赖。
| 层级 | 回答的问题 |
|---|---|
| ODS | 源系统给了我们什么数据? |
| DIM | 业务对象怎样被统一描述? |
| DWD | 每一次业务事实怎样被准确记录? |
| DWS | 哪些主题汇总值得跨应用复用? |
| ADS | 哪些结果应该让报表和应用直接读取? |
例如 dws.channel_day 保持“日期 × 渠道”粒度,是可复用的渠道主题表。ads.channel_performance_day 在它之上增加排名、环比、客单价和退款率,更适合固定经营看板直接使用。
ADS 不应该替代 DWS。将所有报表需求都塞进 DWS,会让通用主题层频繁跟着界面变化;只保留 ADS 又会让临时分析缺少稳定的复用入口。
6. 当前项目边界
当前已经实现
- 固定种子生成九份电商源数据。
- DuckDB 中的 ODS、DIM、DWD、DWS、ADS 五层模型。
- 渠道、商品、用户三个 DWS 主题。
- 经营总览、渠道表现、商品排行、退款监控和复购五类 ADS。
- 584 项分层检查、20 项全仓基线和 53 项统一发布门禁。
- 独立数据库、JSON 质量报告和自动化流水线测试。
当前没有实现
- 数据库日志、消息队列和对象存储增量接入。
- 分区增量、迟到数据处理和失败重跑。
- SCD Type 2 历史维度。
- dbt 模型 DAG、数据血缘平台和质量告警。
- 多环境发布、权限治理和生产资源评估。
- BI 看板本身和 Data Agent 本身。
边界不是缺陷清单,而是教学版本的验收范围。后续章节会给出生产扩展方案,但不会把方案写成已经实现的能力。
7. 与 Data Agent 项目的关系
Data Agent Studio 的电商数仓结构源自本项目的核心模型。为了保证两个商品都能独立学习:
- 本项目自带全部数据、SQL、环境和质量检查。
- Agent 项目也保留自己的数仓副本和构建脚本。
- 两个项目不共享运行文件,也不通过相对路径调用对方。
- 本项目讲清楚可信数据如何产生;Agent 项目讲清楚 AI 如何安全使用数据。
用户可以先学任意一个项目。按完整能力路径学习时,推荐先完成本项目,再进入 Data Agent 的语义层和安全查询部分。
8. 动手任务
任务一:建立业务问题清单
新建 notes/ch01-business-questions.md,分别为业务负责人、渠道运营、商品运营和用户运营写出至少三个问题。
每个问题必须包含:
- 决策角色。
- 指标。
- 分析维度。
- 时间范围。
- 期望的决策动作。
不要只写“查看销售额”,应写成“渠道运营需要比较 6 月各渠道 GMV 和转化率,以决定 7 月预算调整”。
任务二:区分业务过程
从以下字段中判断它们属于订单、支付、退款还是行为过程:
created_at
paid_at
refund_at
event_at
payment_status
refund_reason
session_id
order_item_id
为每个字段说明为什么不能随意换用另一个过程的时间字段或业务键。
任务三:验证独立交付
将本项目目录复制到一个新的临时位置,不保留 Data Agent 项目的任何路径,然后执行:
make setup
make all
验收结果必须包含独立生成的 DuckDB 文件、质量报告和通过的自动化测试。
9. 验收标准
完成本章时,你应该能够明确回答:
- 为什么订单、支付和退款不能合并为同一个业务过程?
dwd.fct_order_item的一行为什么不是一笔订单?- DWS 和 ADS 的职责有什么区别?
- GMV、转化率、退款率分别使用什么事实和时间字段?
- 当前项目已经实现了哪些能力,又明确没有实现哪些生产能力?
- 为什么 Data Agent 项目与本项目有关联,但不是本项目的运行依赖?
同时满足以下机器验收:
make validate -> 584/584 upstream, 53/53 gate, PASS
make test     -> all tests passed
10. 常见错误
把数仓分层当成固定数量的表
分层描述的是责任,不是要求每层只能有几张表。新增模型前应先说明业务过程、粒度和复用范围。
把 ADS 当成所有查询的唯一入口
ADS 适合稳定应用场景。临时下钻和复用分析仍然可能需要 DWS 或受控 DWD 数据。
为了展示技术而虚构生产能力
本项目选择 DuckDB 和全量构建是为了让学习者能够独立跑通。不能因为目录包含五层模型,就宣称已经实现生产级增量、调度和治理。
让另一个项目成为隐藏前置条件
文章可以说明模型来源和学习路径,但安装步骤、数据文件和验收命令必须只依赖当前项目目录。
本章小结
数仓建设从业务问题开始,而不是从创建 schema 开始。本章确定了用户、业务过程、指标树、五层职责和项目边界。下一章将进入九张源表,解释每份数据为什么存在、包含什么业务信号,以及怎样生成可重复的实操数据。